Existe uma elegância quase irresistível em dividir um problema. Um agente investiga, outro implementa, um terceiro testa. O agente principal fica com uma janela de contexto limpa. Tudo parece mais organizado, mais escalável — e até mais econômico.
Mas contexto limpo não é sinônimo de custo baixo. Quando cada subagente é iniciado em uma conversa independente, ele precisa receber instruções, conhecer o objetivo, examinar ferramentas e frequentemente reconstruir um mapa mental que outro agente já havia construído. A economia local pode esconder uma despesa global.
O dado que muda a conversa
Em um relato sobre seu sistema multiagente de pesquisa, a Anthropic observou que agentes consumiam tipicamente cerca de 4 vezes os tokens de uma interação de chat, e sistemas multiagentes cerca de 15 vezes. O número não compara a mesma implementação de programação em três arquiteturas, nem prova que subagentes desperdiçam 15 vezes mais tokens. Ele mostra o tamanho possível da conta quando se adicionam ferramentas, buscas e raciocínio paralelo. [1]
O mesmo relato explica por que isso pode valer a pena: trabalhos de pesquisa com muitas frentes independentes se beneficiam da paralelização. Já tarefas que exigem contexto compartilhado ou têm dependências fortes — caso comum em programação — são menos adequadas. [1]
Otimizar o contexto de um agente não é a mesma coisa que otimizar o sistema inteiro.
Onde o custo invisível aparece?
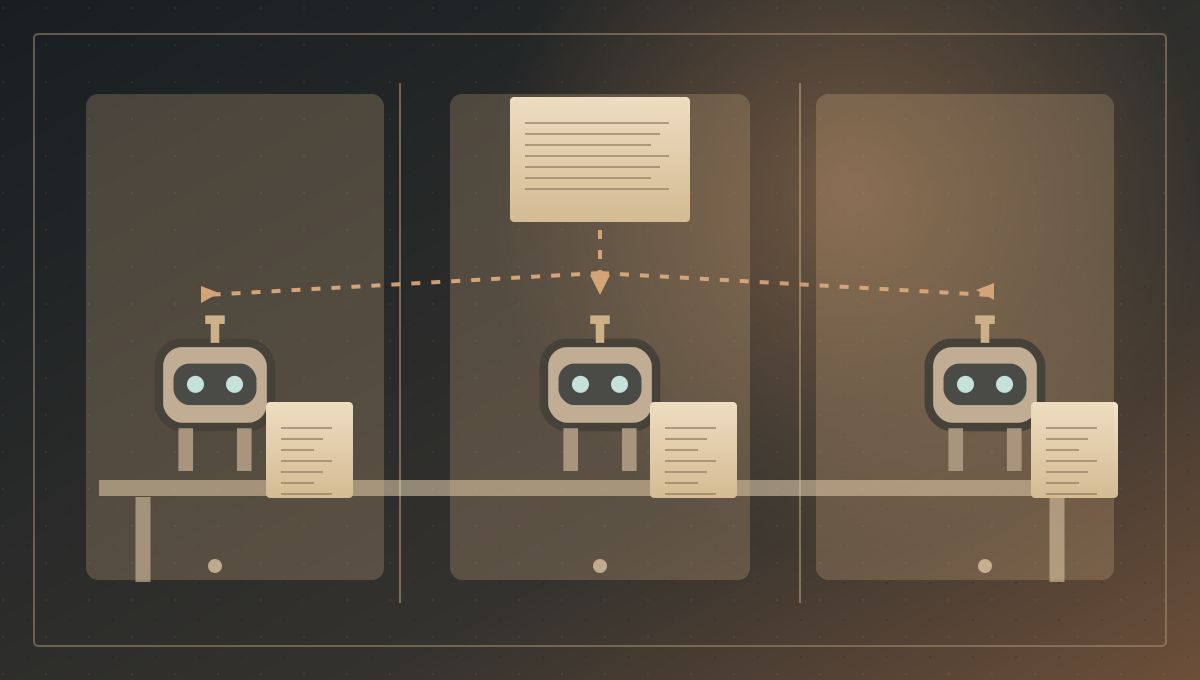
Imagine que três agentes trabalham em módulos diferentes de uma aplicação. Cada um lê as mesmas instruções gerais, a arquitetura do projeto e os arquivos compartilhados. São três caminhos até uma compreensão semelhante. Além dos tokens repetidos, existe o esforço de seleção, interpretação e novas chamadas de ferramenta.
O problema não é a existência de contextos isolados. O isolamento pode proteger a qualidade da investigação, evitar uma janela principal poluída e tornar trabalhos independentes mais rápidos. O problema é delegar sem calcular o custo de entrada, coordenação e síntese.
Cache muda a conta — mas não a pergunta
O prompt cache permite reutilizar prefixos idênticos de prompts por uma fração da tarifa normal. Em outubro de 2026, o preço de leitura no Sonnet 5.5 e no Opus 5.5 é de 5% da tarifa base de entrada; gravações de cinco minutos custam 125% da tarifa de entrada. [2]
Portanto, um milhão de tokens contabilizados pode custar muito menos do que um milhão de tokens de entrada não armazenada. Mas o cache não torna o contexto menor: ele reduz o preço de reprocessar prefixos compatíveis.
Há duas armadilhas adicionais. Mudanças no início do prompt, na definição das ferramentas ou na ordem das instruções podem quebrar o cache; e chamadas realmente simultâneas talvez não reutilizem uma entrada que ainda está sendo criada. [3]
Três estratégias em disputa
| Estratégia | Ganha em | Paga com |
|---|---|---|
| Agente único | Continuidade e pouco handoff | Contexto que cresce e saídas volumosas |
| Muitos subagentes | Paralelismo e isolamento | Inicializações, repetição e coordenação |
| Delegação seletiva | Equilíbrio entre isolamento e economia | Planejamento e instrumentação |
O método mais promissor
- Use um único agente para trabalho pequeno e interdependente. Não delegue uma alteração de um arquivo apenas para limpar a janela.
- Delegue exploração volumosa. Peça a um agente que encontre os arquivos relevantes e devolva caminhos, evidências e decisões — não cem páginas de logs.
- Envie handoffs mínimos e verificáveis. Objetivo, limites, caminhos de arquivos, contratos e critérios de aceitação. Evite retransmitir toda a conversa.
- Mantenha o prefixo estável. Coloque ferramentas, regras e contexto duradouro antes das mensagens variáveis, e meça cache hits em vez de presumir que acontecem.
- Limite o fan-out. Mais agentes só compensam se houver trabalho genuinamente independente ou ganho de qualidade suficiente.
- Compare tarefas concluídas. Registre custo, latência, acerto dos testes, tokens por categoria e retrabalho.
Uma hipótese para testar, não um dogma
Minha hipótese é que boa parte da ineficiência não vem apenas de repetir tokens, mas de repetir descobertas: subagentes que vasculham o mesmo repositório e tomam novamente decisões que já poderiam ter sido preservadas em um resumo de handoff.
Para validar isso, eu compararia o mesmo conjunto de tarefas, em várias repetições, usando (A) agente único, (B) subagentes sem otimização e (C) subagentes seletivos com handoff estruturado e cache. Manteria o mesmo modelo, o mesmo código de partida e os mesmos testes. A métrica principal seria custo por tarefa concluída corretamente, acompanhada de tempo total.
É possível que a configuração multiagente consuma mais tokens e ainda seja a vencedora: quando economiza muito tempo ou produz um resultado melhor, o investimento adicional pode fazer sentido. O contrário também é possível.
O contexto ideal não é o menor possível. É o menor contexto que evita ter de descobrir a mesma coisa duas vezes.
Antes de chamar outro agente, vale fazer uma pergunta pouco glamorosa: ele vai produzir conhecimento novo ou apenas reaprender o que já sabemos?